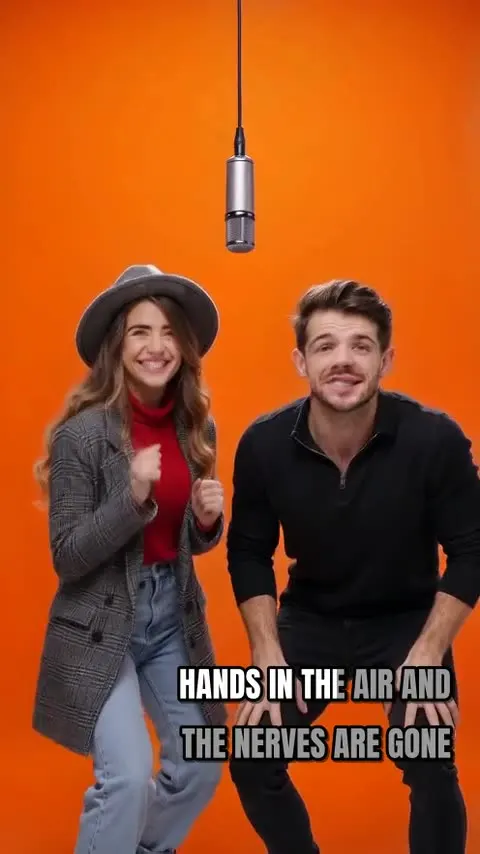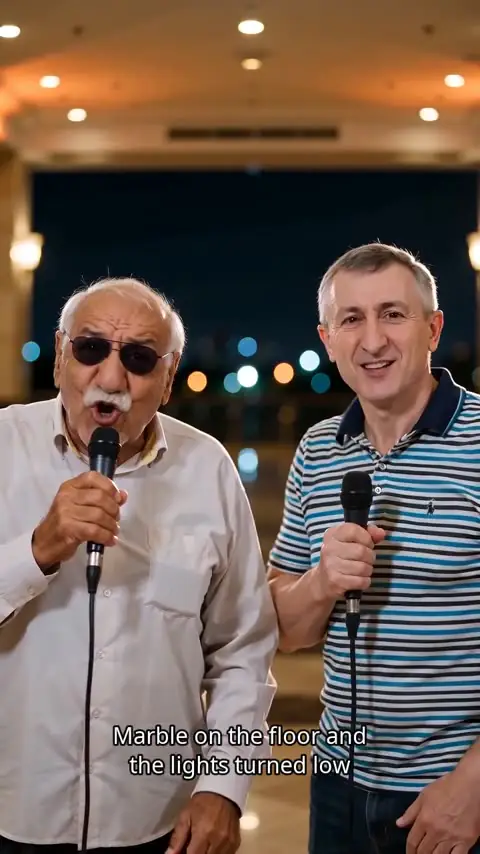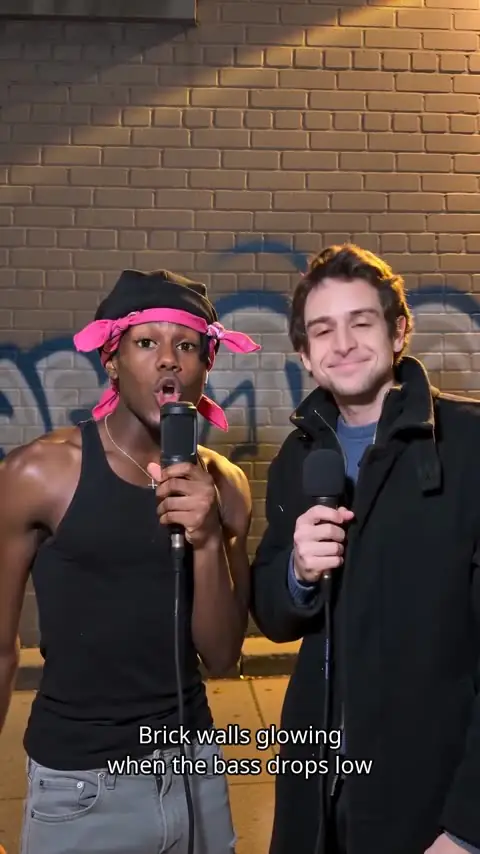
场景长什么样
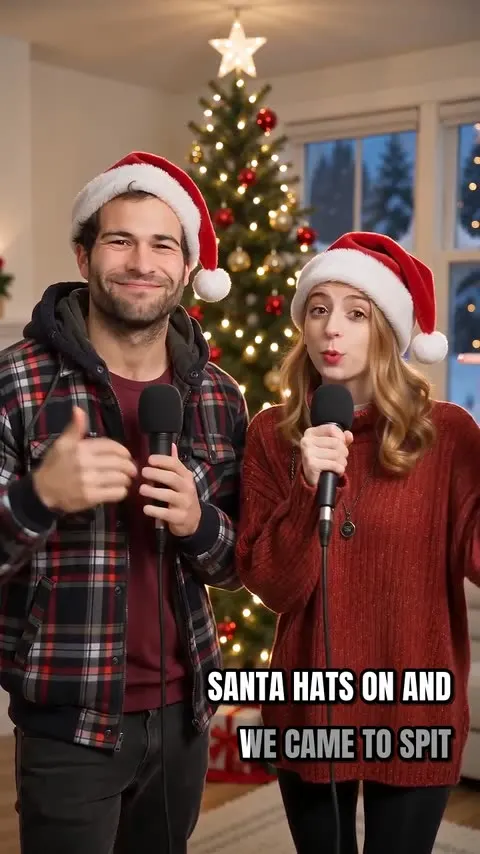
平安夜温馨的客厅:表演者身后是挂满红色和金色彩球、亮着暖色小灯的圣诞树,树下堆着包好的礼物,旁边是挂着花环和圣诞袜的壁炉,结霜的窗外飘着雪。两个人都戴着红白圣诞帽,其余衣着和照片一致。
真实样片 · 同款流程
用到的两张照片、每一步流程、具体参数、5 个画面和完整歌词,都来自这条样片本身。
每人一张清晰的照片。
选「圣诞夜」,配上 4 句原创歌词。
对口型、动作和原创伴奏一起生成,通常约 5 分钟。
歌词作为字幕烧进画面,响度统一到 -14 LUFS。
720×1280 竖屏视频,带声音。
点一下画面,视频就会跳到对应的时刻。
按样片里唱的原样展示。你的视频会有自己的歌词:按你的话题生成,或者你自己写。
这条样片和创作器走的是同一套流程:同样的模型档位、参数和字幕渲染。你的视频会用你的照片和歌词全新生成,人物、动作和细节都会不一样。
场景的样子、适合的主题、一条小建议,以及推荐的设置。
平安夜温馨的客厅:表演者身后是挂满红色和金色彩球、亮着暖色小灯的圣诞树,树下堆着包好的礼物,旁边是挂着花环和圣诞袜的壁炉,结霜的窗外飘着雪。两个人都戴着红白圣诞帽,其余衣着和照片一致。
光线温暖、均匀的照片和圣诞树的灯光最搭。额头和头发露出来,圣诞帽戴上去更自然;两张脸都不要被遮挡,对口型才会干净。
12 秒、9:16 适合 Reels 和抖音;发到家庭群里,1:1 也很合适。
AI Rap Videos 一览
圣诞夜 AI 说唱视频是一段以圣诞夜为场景的短音乐视频:照片里的人会配着节拍、对口型表演一段原创说唱。圣诞树亮着灯,戴上圣诞帽,在壁炉边来一段节日说唱。
圣诞夜适合节日祝福、礼物揭晓和家庭群聊,想在 12 月送上一段节日说唱的搭档都可以选它。
上传两张照片或一张合照,保持选中圣诞夜,填写主题或自己的歌词,再选择 8、12 或 15 秒。生成通常需要几分钟,完成后视频会出现在“我的视频”里。
常见问题
创作第一支视频前,你需要了解的事。
会。两位表演者逐句轮流唱:单数句由第一张照片(合照里左边的人)来唱,双数句由第二位来唱。想换谁先开口,交换两张照片即可。
可以,写在主题或自己的歌词里都行。主题尽量简短,大约 40 个字符以内。生日、相识、做饭和团队胜利这几类主题都有专门的歌词。
可以。最多贴 8 行,总共 300 个字符,每行不超过 80 个字符。表演者会按原词完整唱一遍,不过 AI 表演仍可能有细微偏差。不允许照搬已有歌曲的歌词。
嘴型会逐句跟着生成的人声走。短而清楚的句子最准;语速很快或绕口令式的歌词更难对上,所以每次生成的效果可能略有不同。
会以你的照片为基础,但视频是生成出来的,脸部、手部和小细节可能会有些变化。清晰、正面、光线均匀的照片最接近本人。
有。说唱视频会把歌词作为字幕直接烧录进画面,预览和成片都有,无法关闭。照片特效没有字幕。
说唱视频为 8、12 或 15 秒,照片特效为 5 或 10 秒。清晰度可选 480p、720p 或 1080p(1080p 需要 Pro 或 Ultra),画幅可选 9:16、1:1 或 16:9。下载文件为 MP4。
它们是不同的视频模型:Standard 均衡,Fast 更快,Pro 细节更好,Ultra 是高配选项。价格取决于模型、清晰度和时长,生成前创作页会显示具体价格。
换一个场景,换一个故事,主角依然是你们。